
Что такое Security Operations Center
Security Operation Center (SOC) — сервис, который помогает защищать ИТ-инфраструктуру компании, обнаруживая атаки раньше, чем злоумышленники успевают нанести вред. Основная задача — мониторинг и предотвращение киберугроз в реальном времени.
Кому подходит внешний SOC
- Нет команды 24×7;
- SIEM есть, но ее некому сопровождать;
- Требуется закрыть требования КИИ/внутреннего аудита;
- Нужно усилить мониторинг облака, филиалов, серверов и рабочих станций.
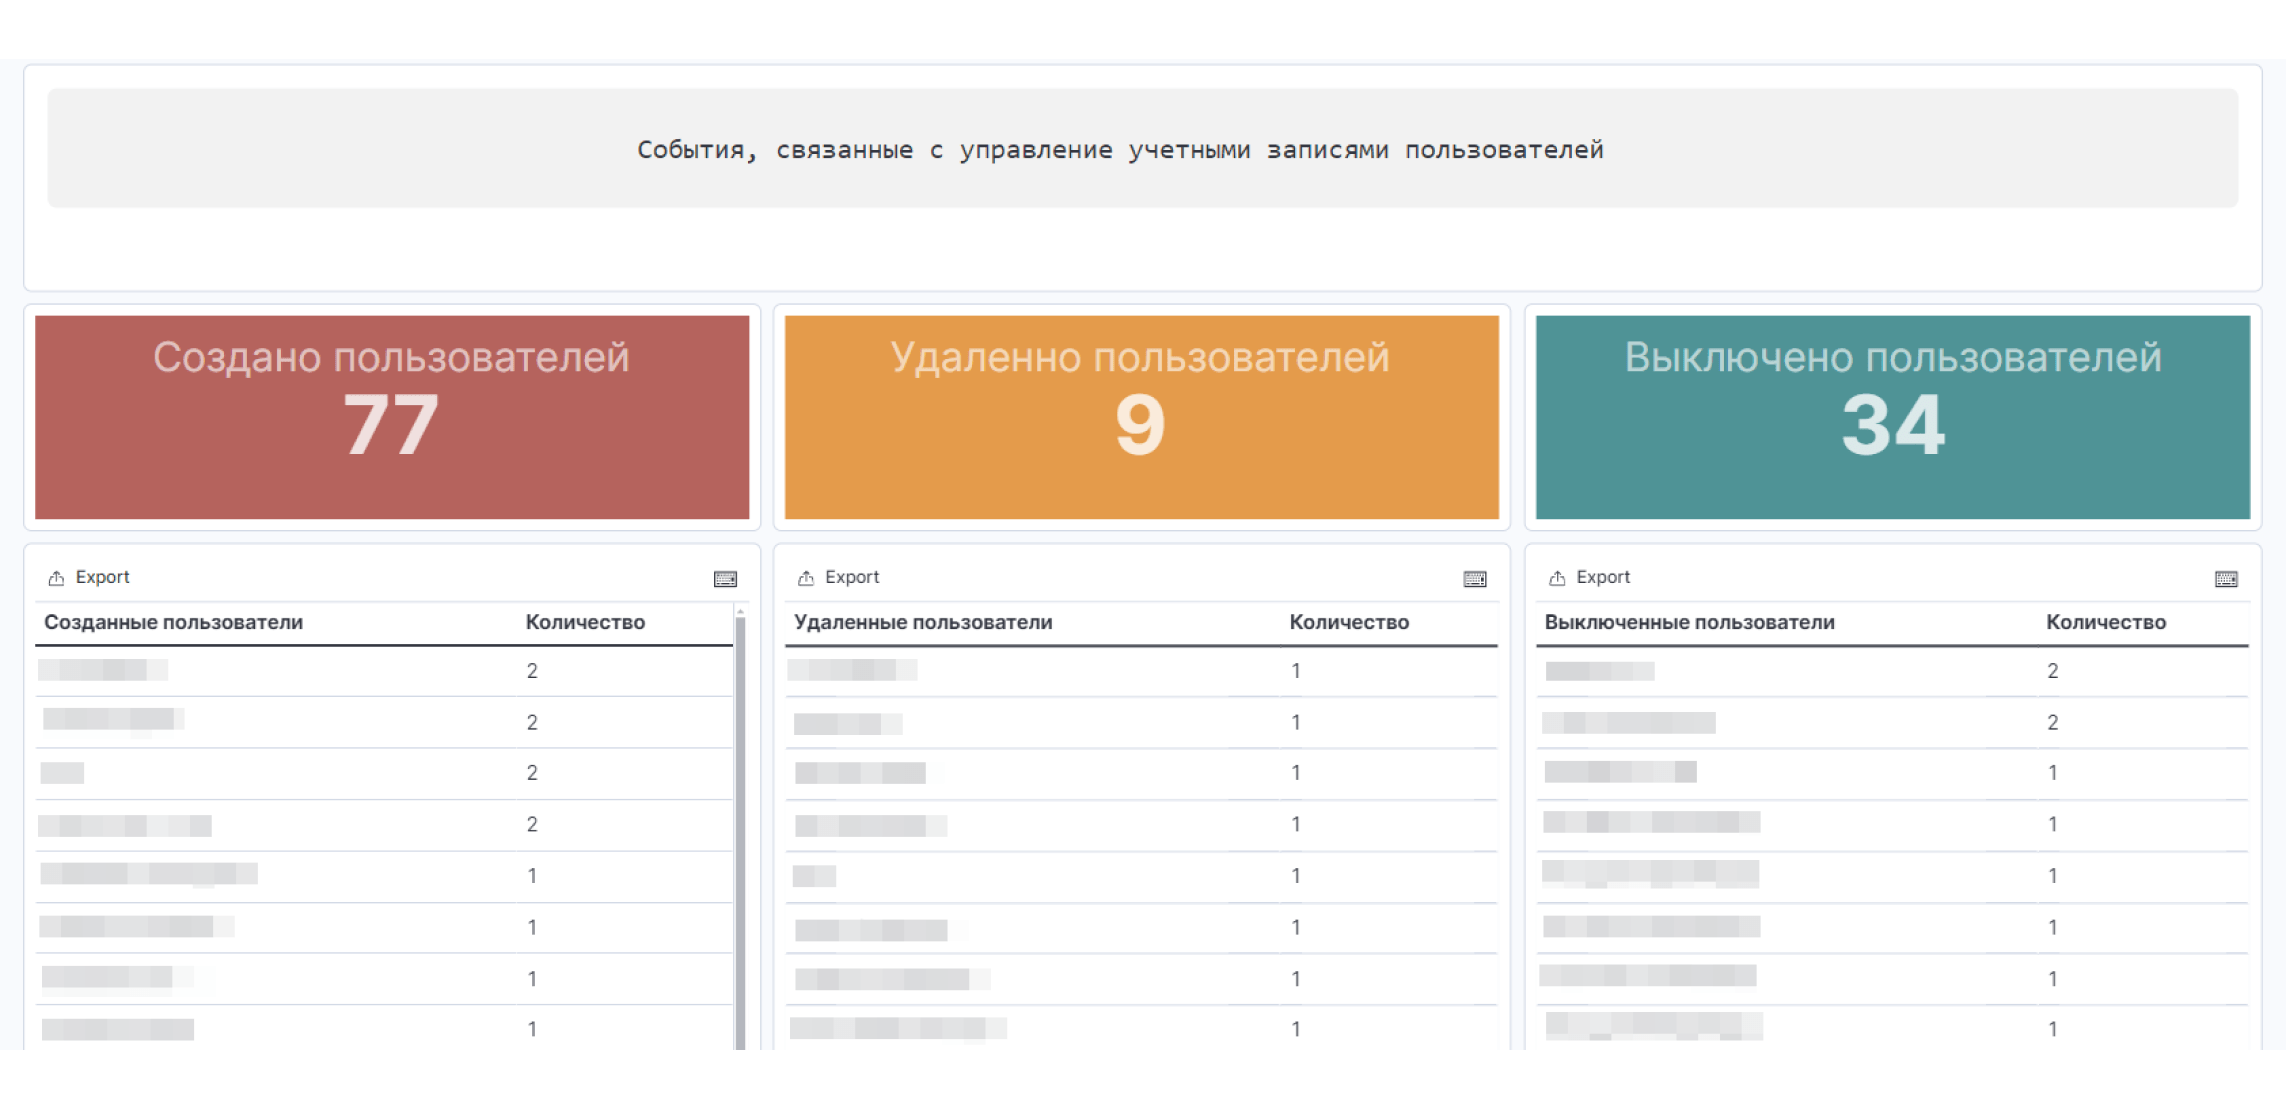
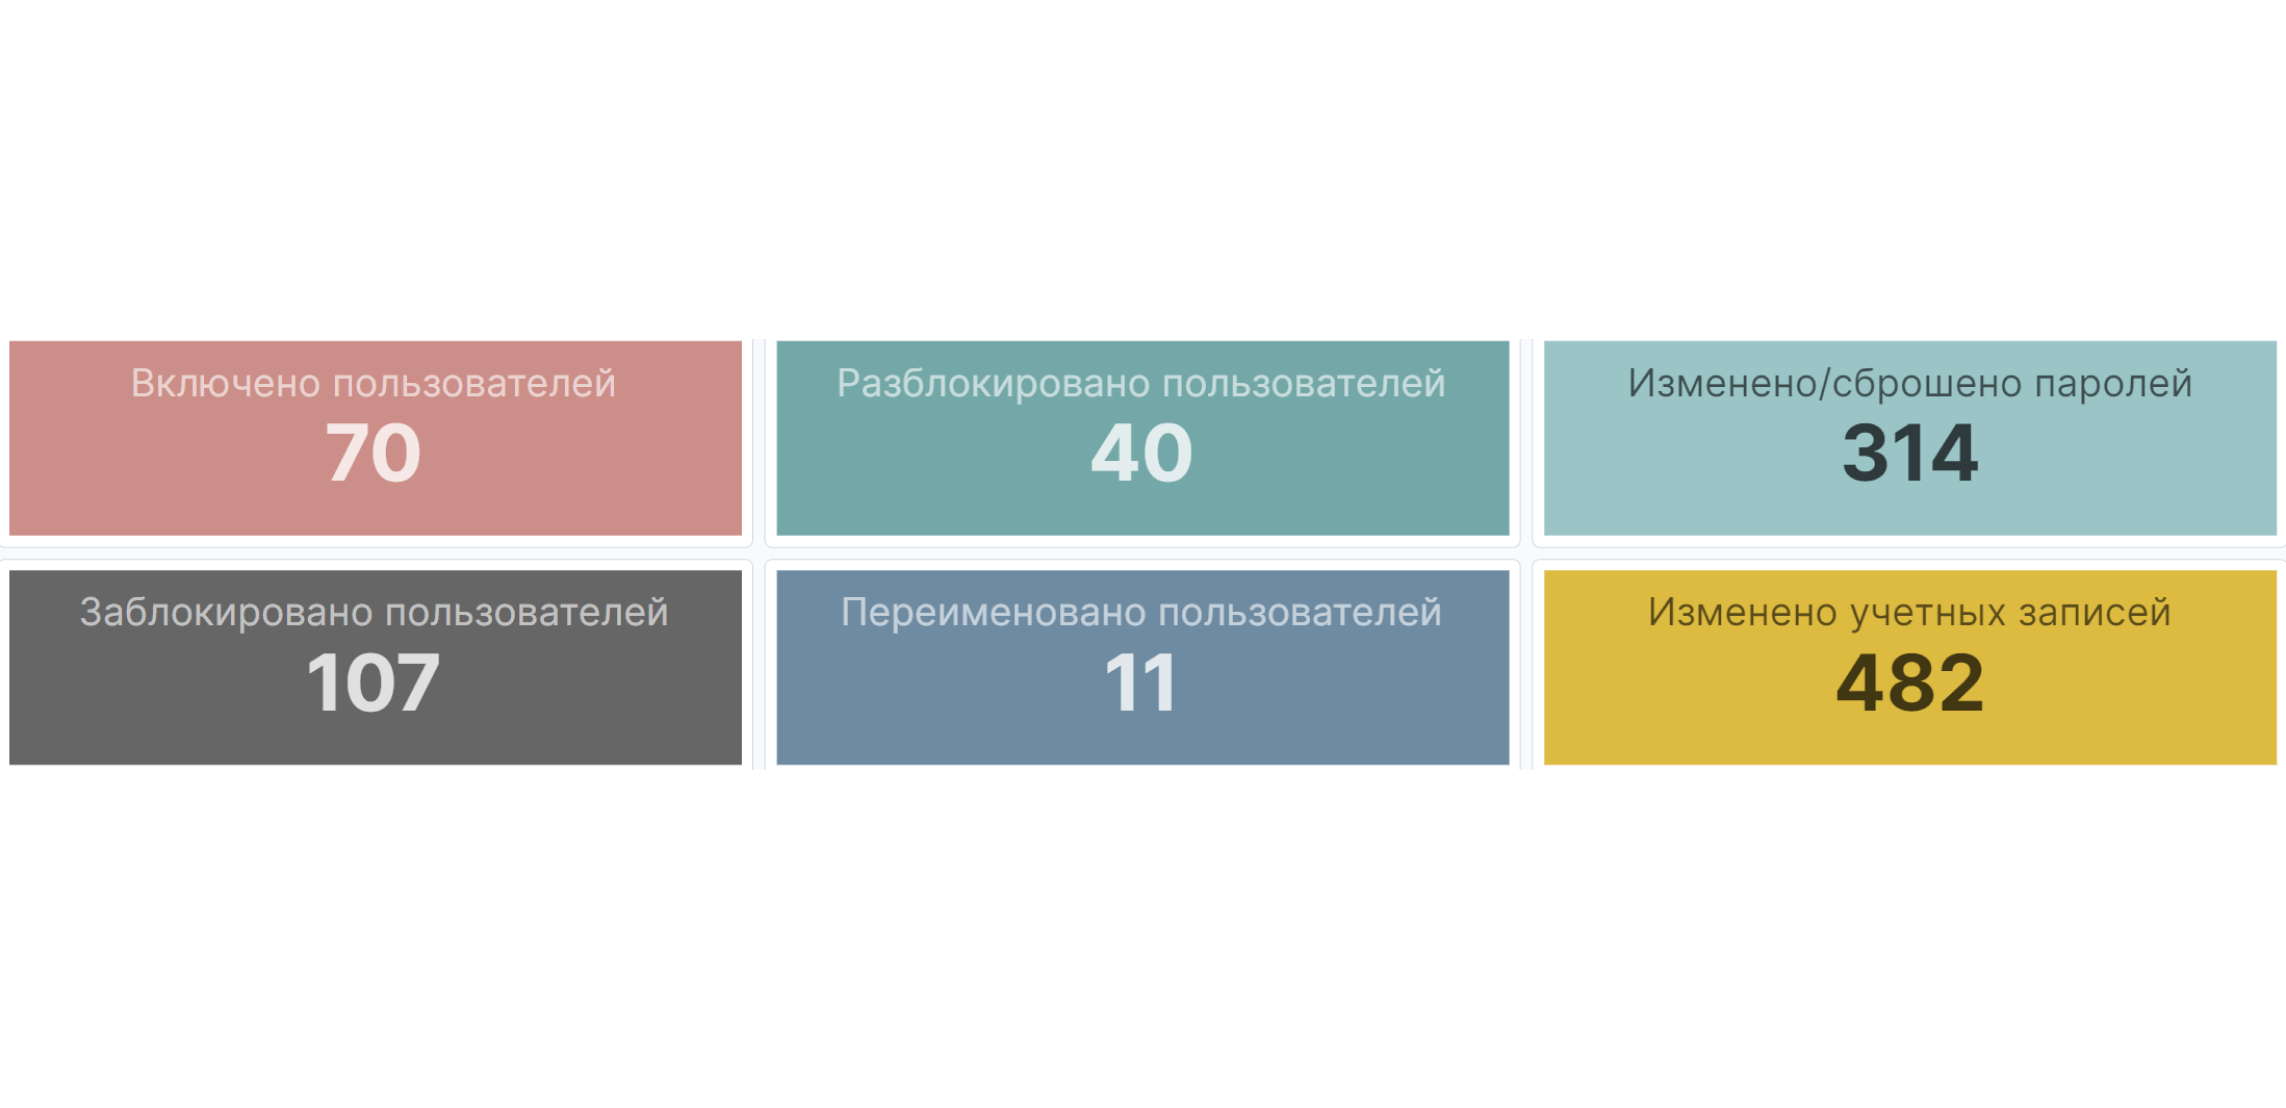
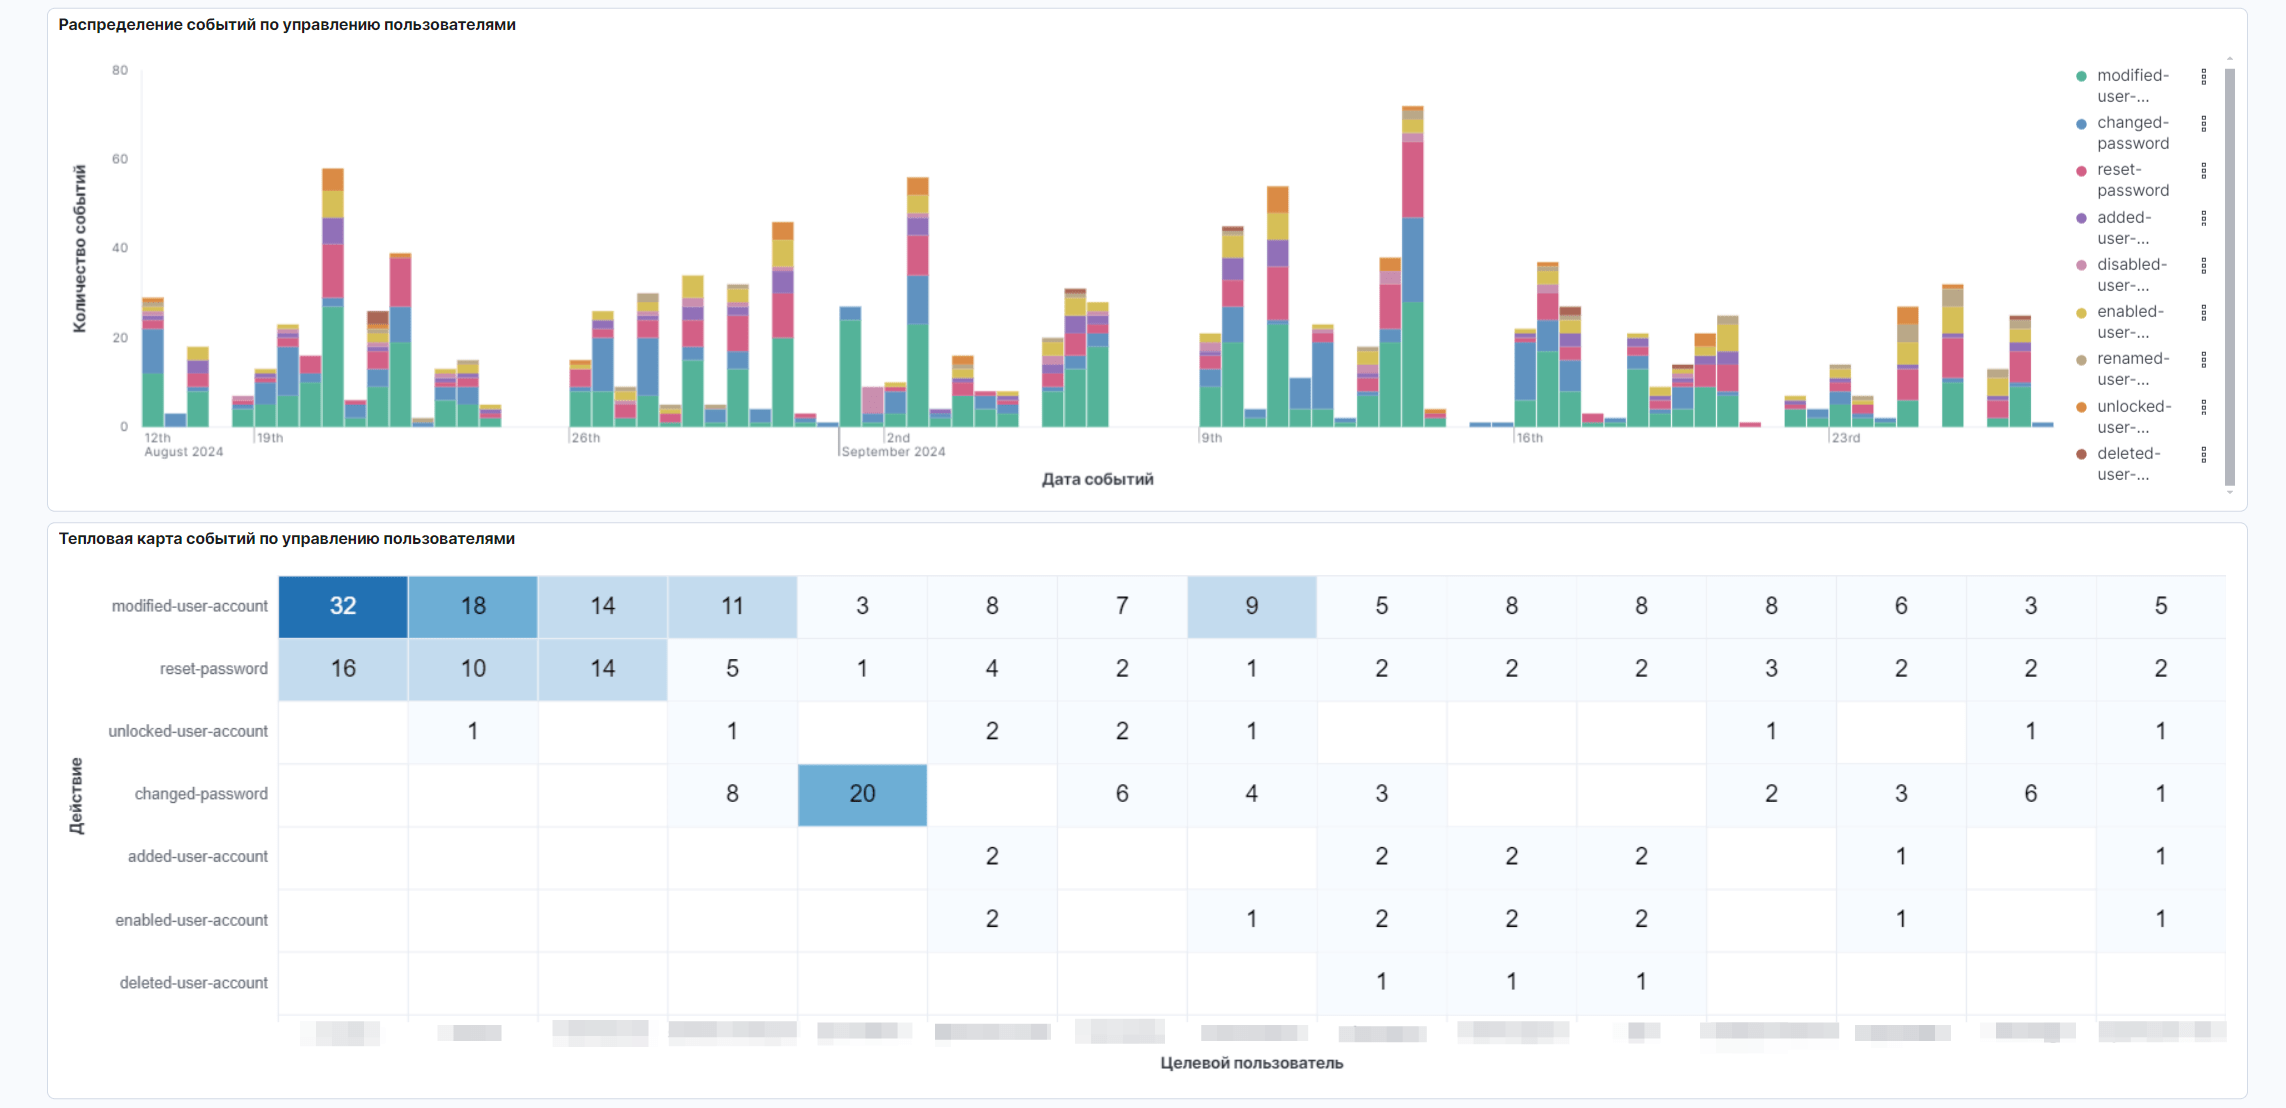
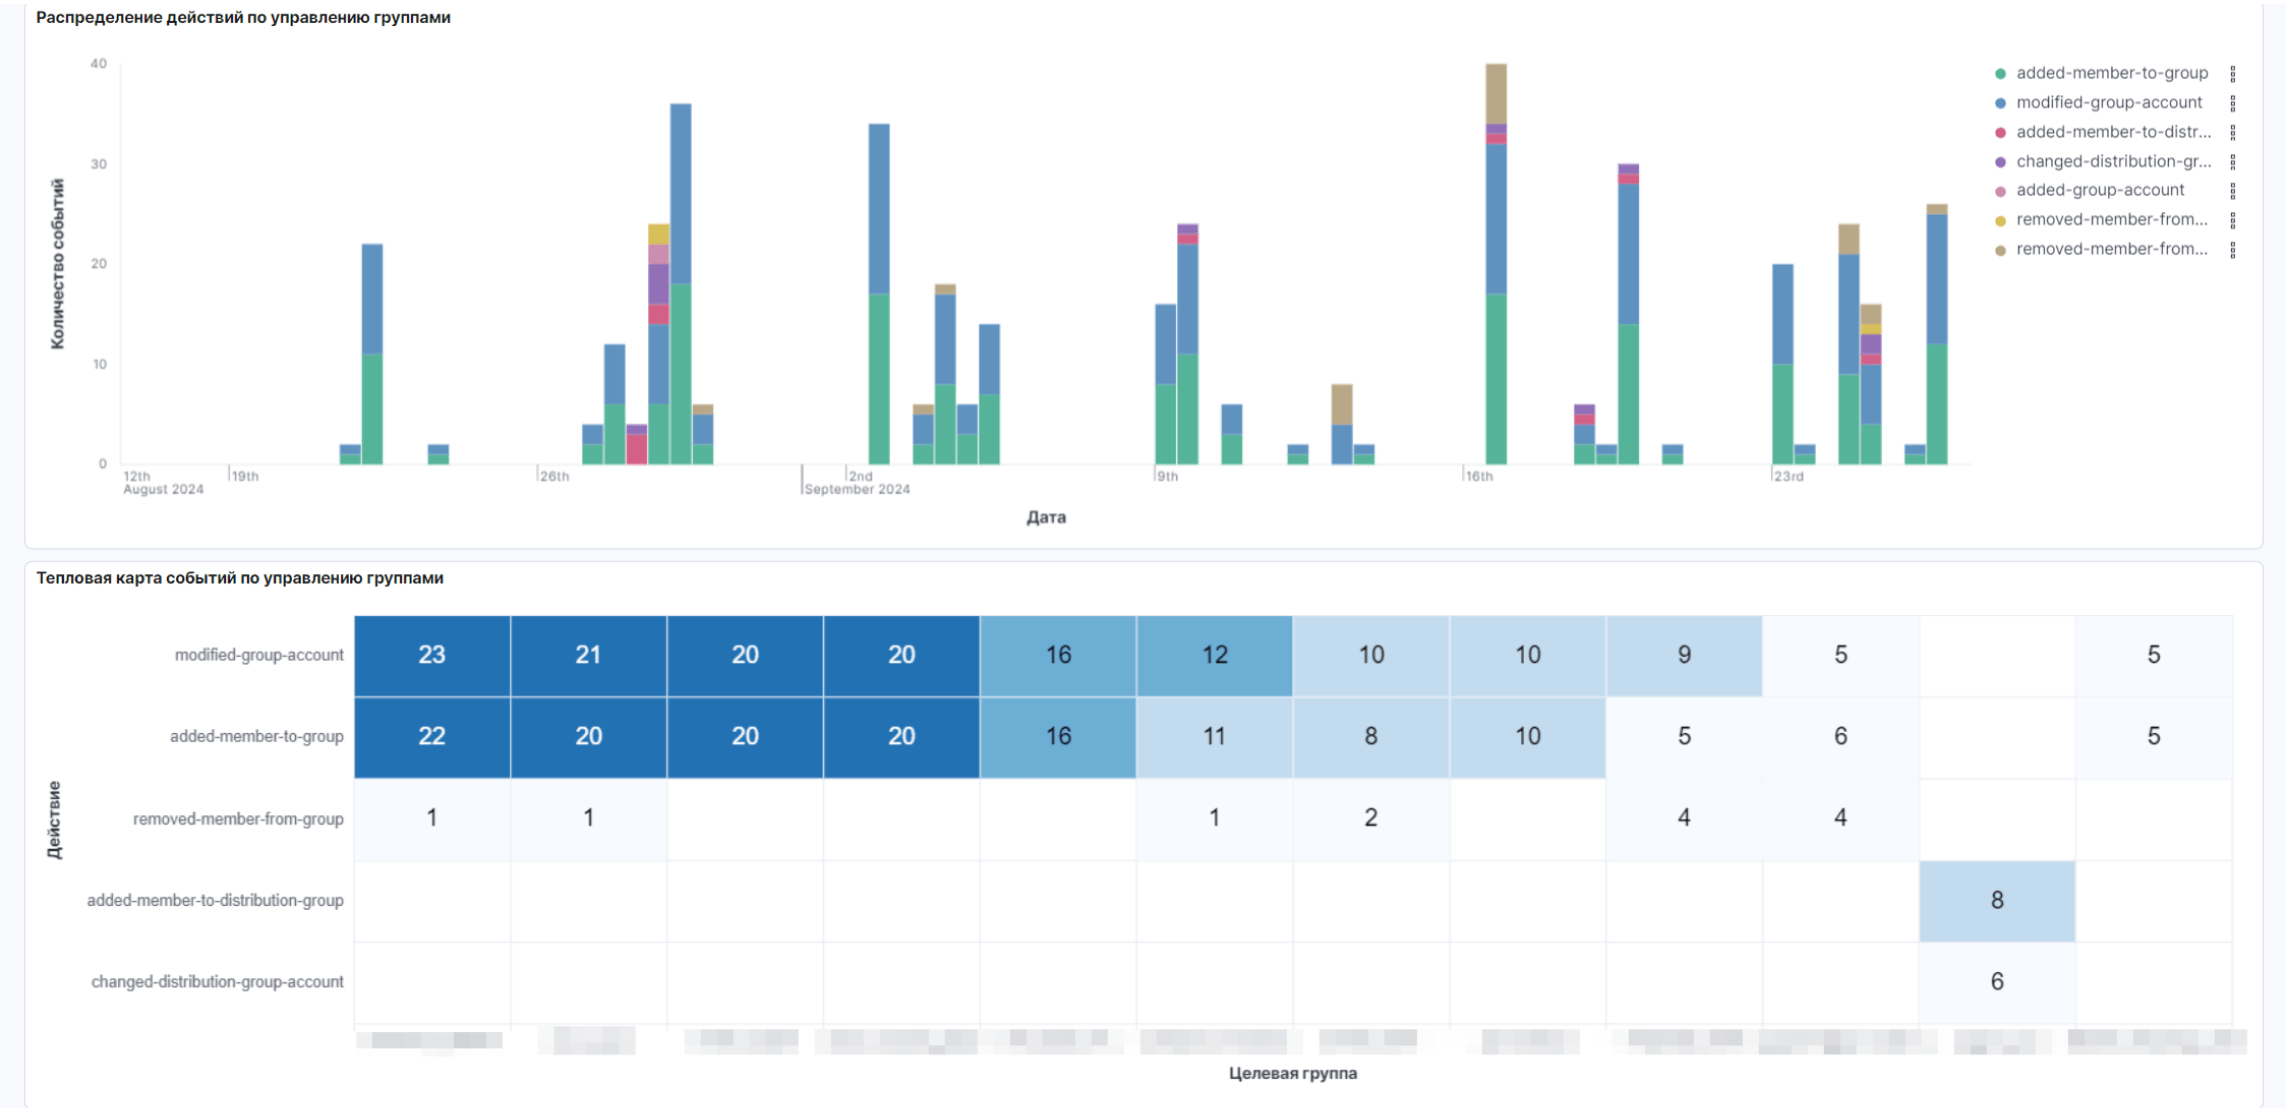
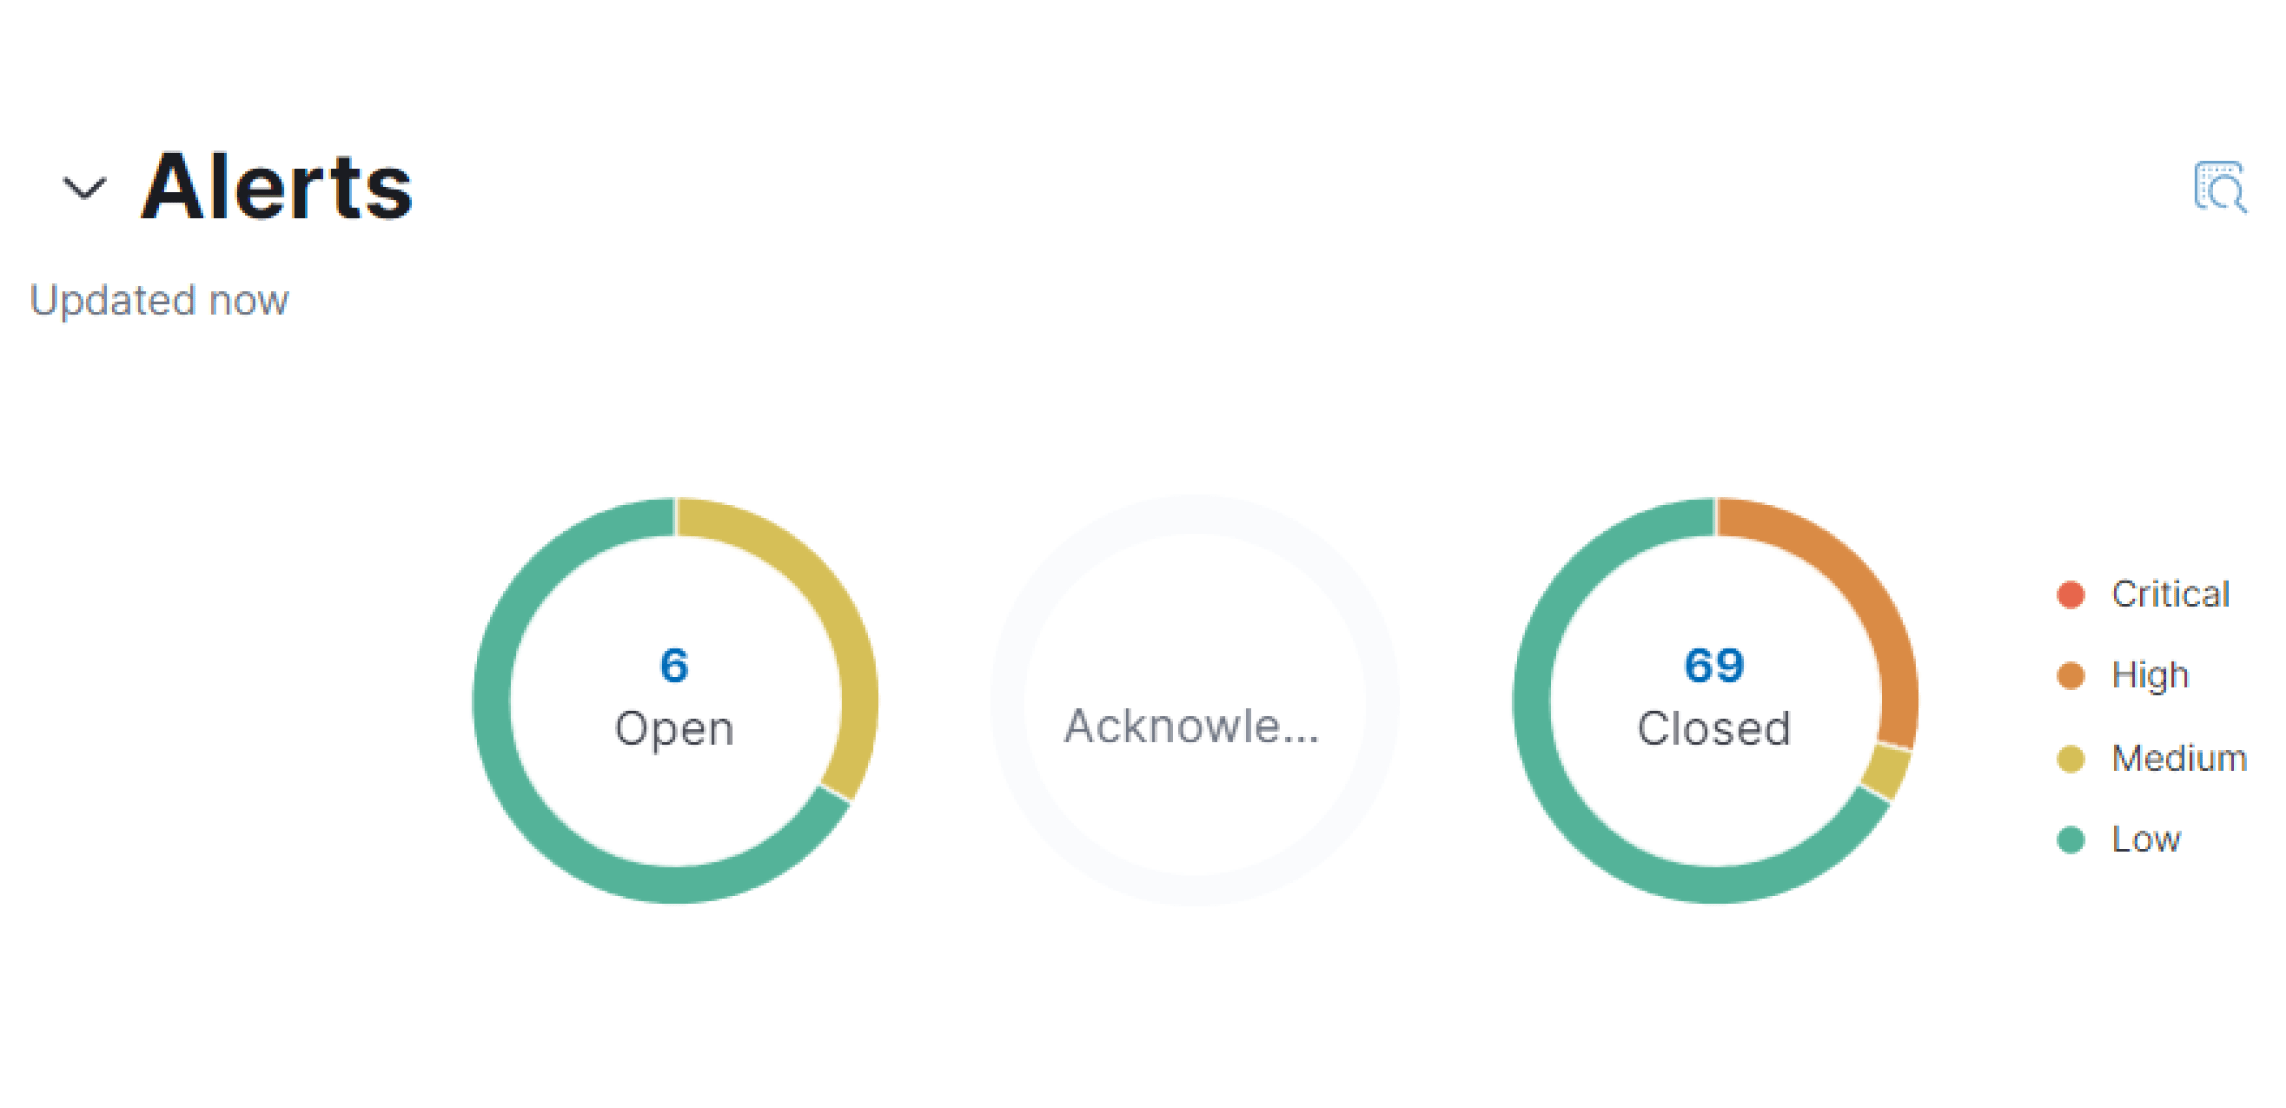
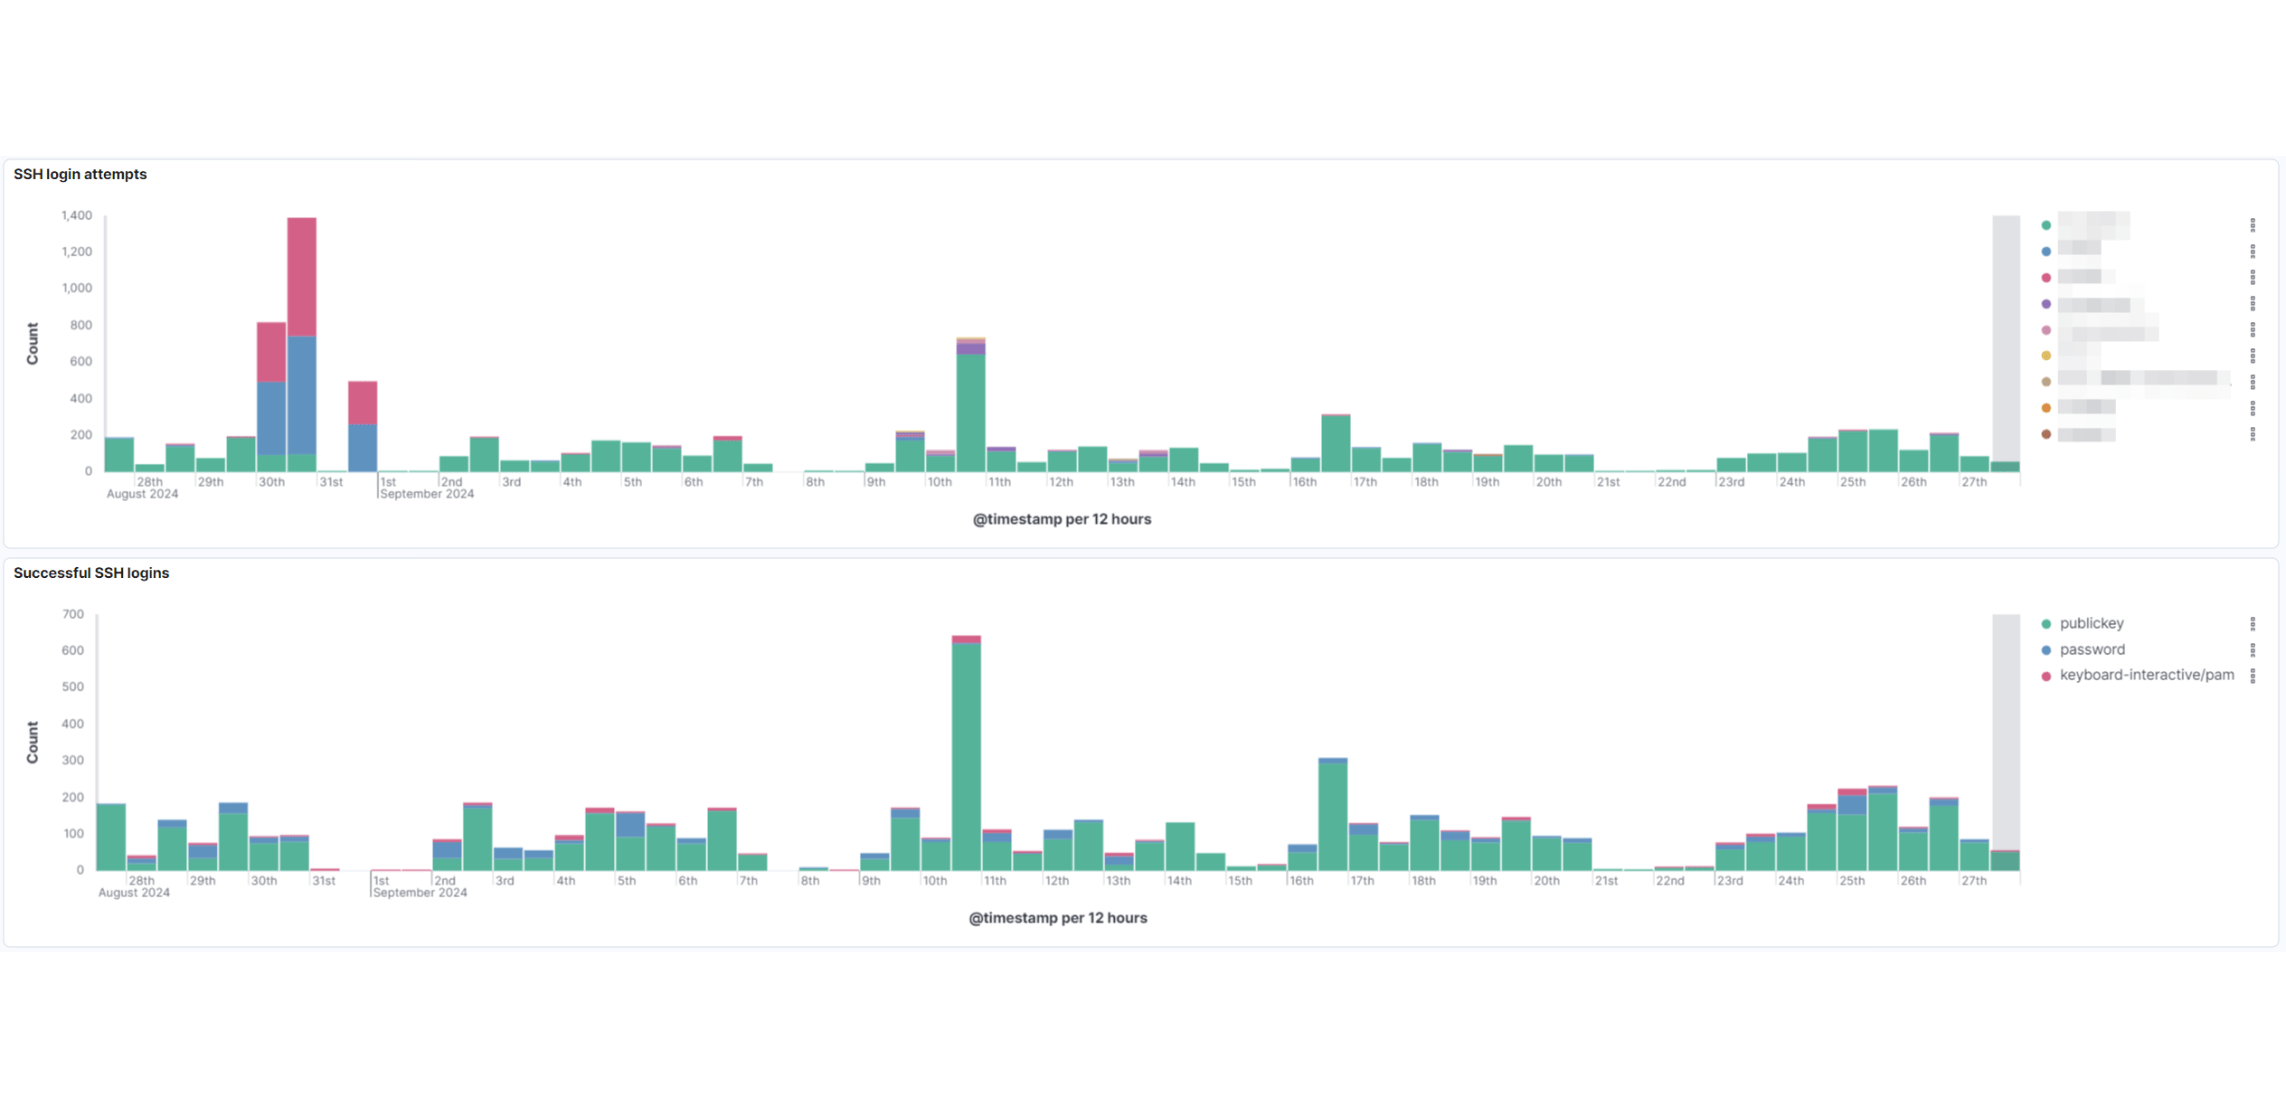
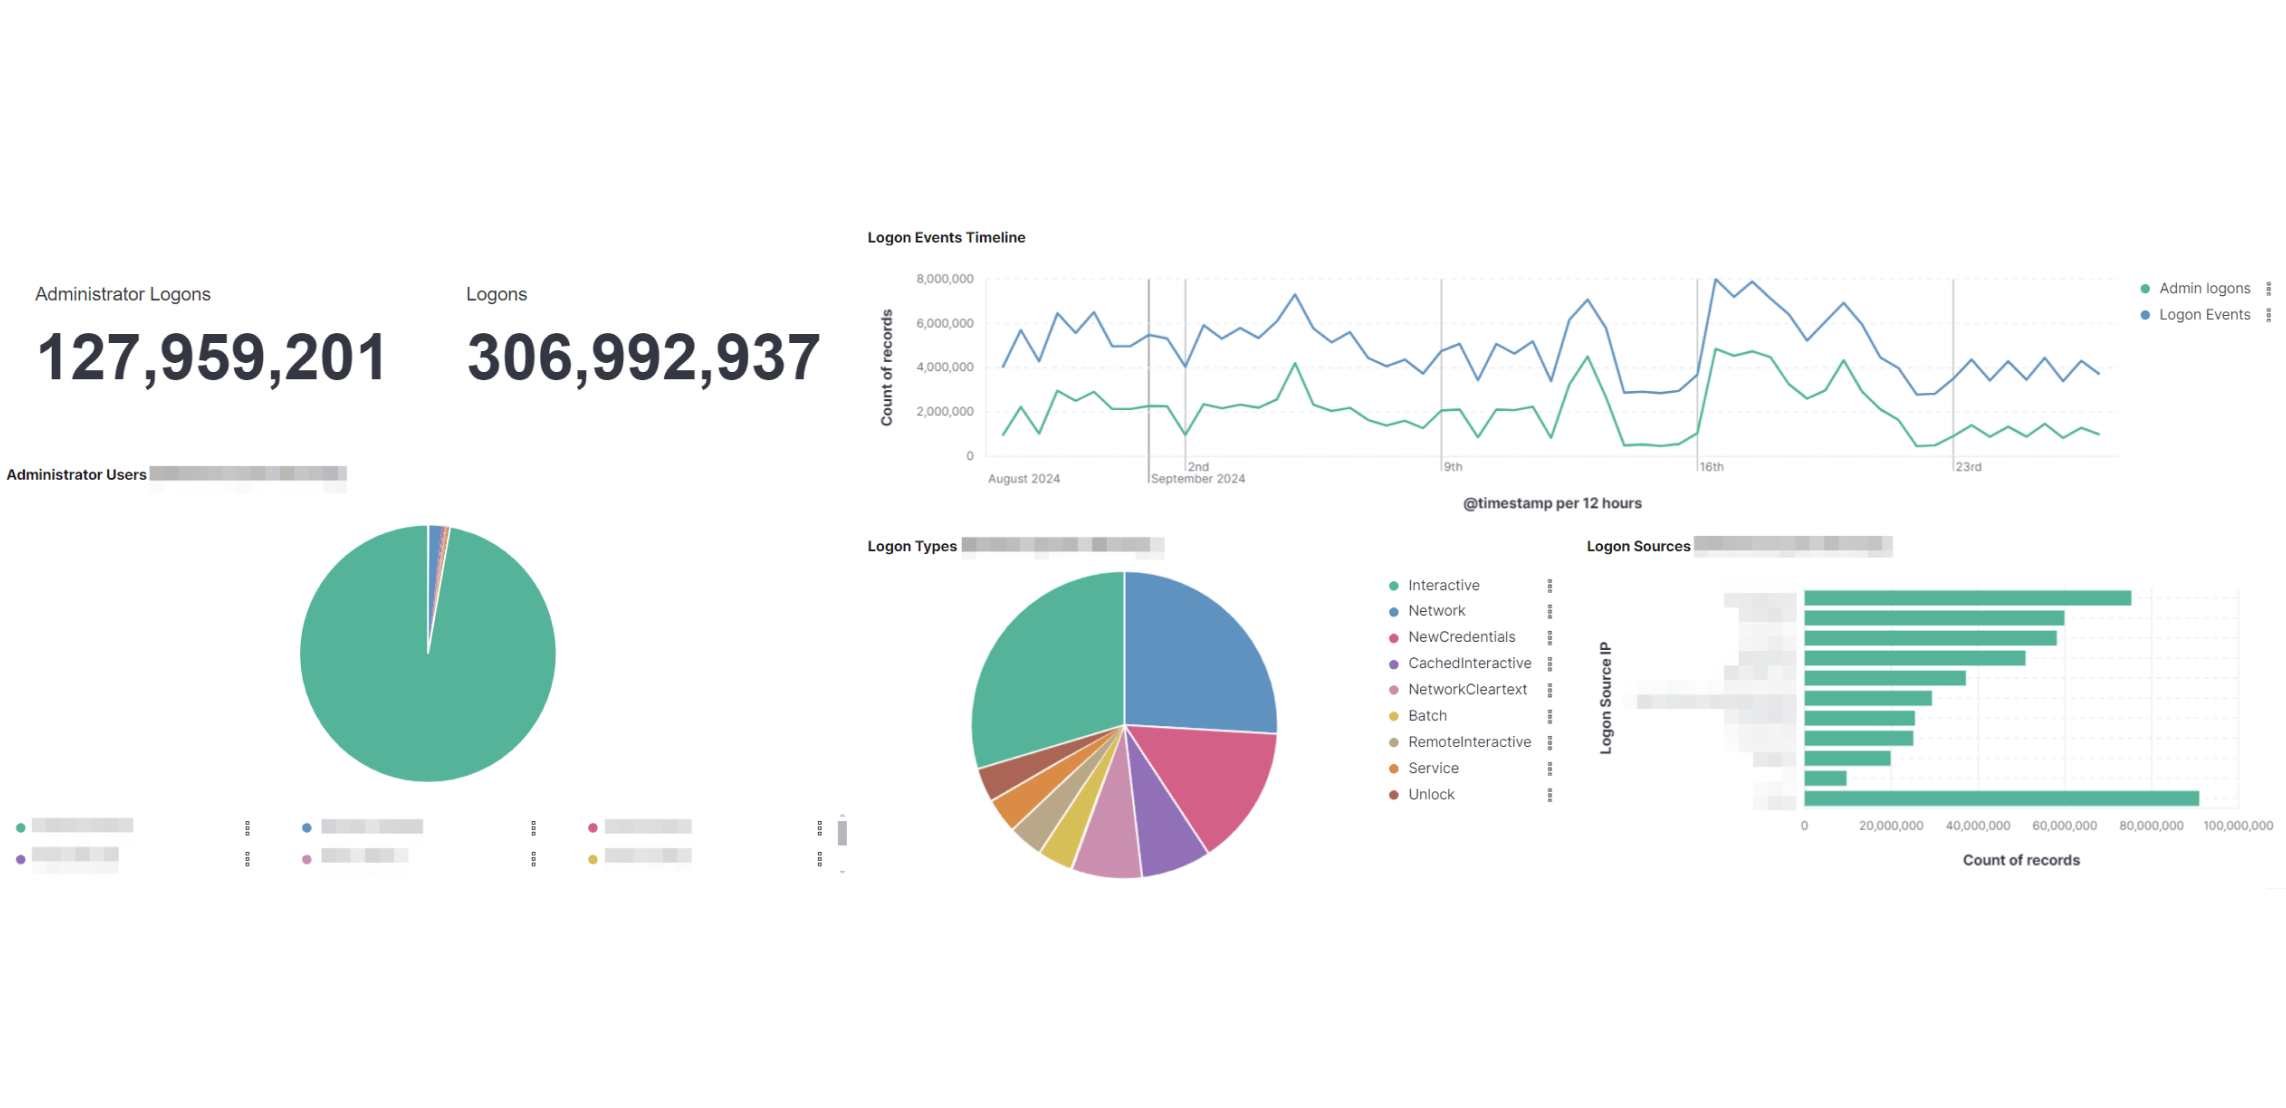
Зачем это бизнесу
Предотвращение кибератак
Снижает вероятность успешных атак и уменьшает связанные риски
Поддержание непрерывности работы
Обеспечивает стабильность функционирования систем и предотвращает простои
Соответствие требованиям
Помогает выполнять законодательные и отраслевые стандарты по защите данных
Что входит в услугу
- Сбор журналов событий на компонентах инфраструктуры
- Детектирующая логика обнаружения атак
- Время реагирования на инциденты
- Порядок уведомления об инцидентах и подозрительных действиях
- Качество сведений для реагирования на инциденты
- Клиентский кабинет SOC
Как SOC обрабатывает подозрительные события
| Приоритет | Время оповещения | Способ оповещения |
| Критический | Не более 30 минут после выявления подозрительного события | 1. Личный кабинет
2. Сообщение в Telegram-чат 3. Звонки на телефоны / электронная почта и др. |
| Высокий | Не более 40 минут после выявления подозрительного события | |
| Средний | Не более 60 минут после выявления подозрительного события | |
| Низкий | Не более 90 минут после выявления подозрительного события |
Типовые анализируемые события
2 x 48 core
Запуск/остановка служб
и процессов в ОС
Изменение привилегий
для учетной записи
Попытки сброса/
изменения пароля
Неуспешный вход учетной записи в систему
в рабочее/не рабочее время
Изменение политик регистрации
событий безопасности
Изменение параметров технических средств
защиты информации
Множественные неуспешные попытки аутентификации
Очистка/удаление журналов регистрации событий
Отключение/изменения уровня логирования
Выход из системы
Изменение привилегий для учетной записи
Запуск несанкционированых скриптов
Типовые источники событий
- Система антивирусной защиты от вредоносного ПО
- Системы защиты от несанкционированного доступа
- IPS/IDS (Система обнаружения/предотвращения вторжений)
- NGFW Next-Generation Firewall
- WAF (web application firewall)
- Другие CPB
- Электронная почта
- Централизованное управления виртуальной инфраструктурой
- Система управления базами данных (СУБД)
- Веб сервер
- Система резервного копирования и архивирования
- CRM (customer relationship management)
- IDM (identity and Access Management) / PAM (privileged access management)
- ERP (Enterprise Resource Planning)
Этапы внедрения и эксплуатации
-
Установка сетевой связанности между инфраструктурой Клиента и сервисом SOC
Для подключения необходим сетевой инженер Клиента. Подключение производится совместно с командой сервиса SOC. От 1 до 3 рабочих дней
-
Предоставление дистрибутива агентов SOC
Со стороны клиента не требуются специалисты.
В течение суток
-
Установка агентов на компоненты ИТ-инфраструктуры Клиента
Для установки агентов со стороны Клиента необходим системный администратор отвечающий за установку ПО на серверах, и рабочих станциях. От 1 до 3 рабочих дней
-
Установка лог-коллектора
Для установки агентов со стороны Клиента необходим системный администратор отвечающий за установку новых компонентов ИТ-инфраструктуры. В зависимости от типа компонента возможно безагентное подключение к сервису SOC. При таком способе подключения в ИТ-инфраструктуру клиента устанавливается ВМ. Образ виртуальной машины лог-коллектора предоставляется специалистами сервиса SOC. От 1 до 3 рабочих дней
-
Настройка передачи событий безопасности с сетевого оборудования Клиента
Для настройки передачи событий безопасности с сетевого оборудования со стороны Клиента потребуется сетевой инженер или системный администратор. От 1 до 2 рабочих дней
-
Настройка расширенного логирования на всех компонентах ИТ-инфраструктуры Клиента
Со стороны Клиента потребуется системный и сетевой инженеры. Инструкции по настройке предоставляют специалисты сервиса SOC. от 1 до 3 рабочих дней
-
Передача, анализ, хранение и непрерывный мониторинг событий безопасности в режиме 24/7
После успешного внедрения, сервис переходит в режим постоянного мониторинга, в рамках которого специалисты на разных уровнях поддержки анализируют все подозрительные события ИБ. Реакция Клиента требуется только в случае подтверждения подозрительных событий или инцидентов ИБ.
Формирование стоимости услуг центра мониторинга безопасности (SOC)
Цена определяется несколькими ключевыми параметрами:
Количество СЗИ
Чем больше систем требуется подключить и контролировать, тем выше объем обрабатываемых данных и трудозатраты аналитиков.
Количество компонентов инфраструктуры
Серверы, рабочие станции, сети и облачные ресурсы формируют общий периметр мониторинга.
EPS (Events Per Second)
Показатель интенсивности потока событий. Чем выше EPS, тем мощнее должны быть платформы анализа и корреляции данных.
Услуга позволяет выполнить требования
- ГОСТ Р 57580.1-2017: меры МАС.1-МАС.8, МАС.10-МАС.23 (возможный прирост к оценке по ГОСТ — 0,06);
- Приказ ФСТЭК России №21 и №17: требования РСБ.1-РСБ.7, РСБ.8 (17-й приказ);
- ФЗ-187: Статья 4. Принципы обеспечения безопасности критической информационной инфраструктуры, включая требования по ГосСОПКА;
- PCI DSS: требования 10.1 (включая подпункты), 10.2 (включая подпункты), 10.3 (включая подпункты), 10.5 (включая подпункты), 10.6 (включая подпункты), 10.7 (включая подпункты), 10.8.;
- Приказ ФСТЭК России №239: АУД.4-АУД.9.
Команда сервиса SOC
Менеджеры сервиса
Инженеры сервиса
Системные инженеры сервиса
Специалисты по работе с SIEM системой
Аналитики 1-го уровня поддержки
Аналитики 2-го уровня поддержки
Используемые технологии

Личный кабинет сервиса
Централизованная обработка событий ИБ

Компоненты EDR
Предотвращение вредоносной активности на конечных точках: подключенных к сети рабочих станциях, серверах, устройствах Интернета вещей и т.д.

Компоненты Threat Intelligence
База знаний об угрозах, полученных в результате анализа и интерпретации данных
Преимущества от ITGLOBAL.COM Security

Время реакции команды SOC – не более 10 минут в любое время дня и ночи

Условия обслуживания известны заранее и не нарушаются

Предоставление доступа к SIEM-системе для просмотра «сырых» логов и дашбордов

Разработка нестандартных правил корреляции по запросу Клиента
В конце каждого месяца мы предоставляем отчет, в котором:
- Общий перечень событий, зарегистрированных за отчетный период
- Перечень подозрительных событий ИБ, не являющихся инцидентами
- Описание инцидентов ИБ, выявленных за отчетный период
Дополнительно отчет может содержать и другую информацию, относящуюся к результатам оказания Услуги за период.
Наши клиенты


Частые вопросы
SIEM — это программная платформа для сбора, хранения, нормализации и корреляции событий безопасности. Она помогает обнаруживать подозрительную активность в журналах ИТ-систем.
SOC — это услуга и команда специалистов, которые используют SIEM и другие средства защиты для постоянного мониторинга, проверки срабатываний, расследования инцидентов и координации реагирования.
Иными словами, SIEM — инструмент, а SOC — люди, процессы и технологии, которые превращают данные из инструмента в управляемую защиту.
Не обязательно. Возможны разные варианты организации сервиса:
- Подключение существующей SIEM-системы заказчика к процессам мониторинга SOC
- Развертывание или предоставление SIEM как части проекта
- Подключение источников событий к согласованной платформе мониторинга
- Расширение уже используемой инфраструктуры защиты: EDR/XDR, NGFW, WAF, почты, облачных сервисов и других систем
Подход определяется после обследования инфраструктуры, оценки объема событий, требований к хранению данных и задач мониторинга.
К SOC обычно подключают источники, которые помогают выявлять атаки, компрометацию учетных записей, несанкционированный доступ и другие инциденты:
- Серверы Windows и Linux
- Рабочие станции и средства EDR/XDR
- Active Directory, контроллеры домена и системы управления учетными записями
- Межсетевые экраны, VPN-шлюзы, NGFW, IDS/IPS
- Почтовые системы и средства защиты электронной почты
- WAF, веб-серверы, приложения и API
- Облачную инфраструктуру и журналы облачных сервисов
- Системы виртуализации, контейнерные платформы и Kubernetes
- СУБД, корпоративные приложения, CRM, ERP и другие критически важные системы
- DLP, PAM, антивирусные решения и иные средства защиты информации
Окончательный перечень источников определяется на этапе предпроектного обследования.
SOC помогает выявлять и расследовать широкий спектр событий и атак, включая:
- Подбор паролей и атаки на учетные записи
- Подозрительные входы в корпоративные системы и VPN
- Компрометацию привилегированных учетных записей
- Вредоносную активность на рабочих станциях и серверах
- Шифрование файлов и признаки ransomware-атак
- Перемещение злоумышленника внутри сети
- Запуск подозрительных процессов и скриптов
- Несанкционированные изменения в Active Directory
- Аномальную сетевую активность и подозрительные исходящие соединения
- Атаки на веб-приложения и API
- Попытки эксплуатации известных уязвимостей
- Нарушение политик безопасности и признаки утечки данных
Конкретный набор сценариев зависит от состава подключенных систем, отрасли, модели угроз и приоритетов бизнеса.
Процесс работы с инцидентом обычно включает несколько этапов:
- SOC получает и коррелирует события из подключенных источников.
- Аналитик проверяет срабатывание и отделяет реальную угрозу от ложного события.
- Инцидент классифицируется по критичности и влиянию на бизнес.
- Ответственные сотрудники заказчика получают уведомление по согласованному каналу.
- SOC передает сведения о причинах, затронутых системах, индикаторах компрометации и рекомендуемых действиях.
- При необходимости специалисты помогают локализовать инцидент, собрать дополнительную информацию и восстановить хронологию атаки.
- По итогам формируется отчет с рекомендациями по предотвращению повторного инцидента.
SLA — это соглашение об уровне сервиса. Оно фиксирует, как будет организовано взаимодействие между заказчиком и SOC.
В SLA обычно определяют:
- Режим мониторинга
- Время первичной реакции на инциденты разной критичности
- Каналы оповещения: телефон, email, мессенджер, Service Desk или личный кабинет
- Порядок эскалации инцидента
- Состав работ SOC и зоны ответственности сторон
- Регламент предоставления отчетности
- Порядок взаимодействия при критическом инциденте
До запуска сервиса важно согласовать не только время уведомления, но и список сотрудников заказчика, которые могут принимать решения по блокировке или локализации атаки.
Состав и периодичность отчетности определяются договором и SLA. Как правило, SOC предоставляет:
- Оперативные уведомления о подтвержденных инцидентах
- Карточки инцидентов с описанием событий, затронутых систем и рекомендациями
- Регулярные отчеты по событиям и инцидентам
- Статистику по уровню критичности, источникам, типам угроз и динамике атак
- Отчеты по соблюдению SLA
- Рекомендации по настройке средств защиты и снижению рисков
- Отчеты по итогам расследований критичных инцидентов
Отчетность помогает ИТ- и ИБ-руководителям видеть реальную картину угроз, оценивать эффективность защиты и планировать дальнейшее развитие ИБ.
Создание собственного SOC требует существенных инвестиций в технологии, лицензии, хранение данных, регламенты и команду аналитиков разных уровней. Дополнительно необходимо обеспечить сменную работу, непрерывность процессов, обучение сотрудников и развитие сценариев обнаружения.
Внешний SOC позволяет:
- Быстрее запустить мониторинг
- Получить доступ к профильной экспертизе и аналитикам ИБ
- Организовать мониторинг без формирования большой внутренней команды
- Планировать расходы по сервисной модели
- Масштабировать услугу при росте инфраструктуры
- Сосредоточить внутреннюю ИТ-команду на ключевых задачах бизнеса
Собственный SOC может быть оправдан в очень крупных организациях с высокой зрелостью ИБ, большим объемом инфраструктуры и сформированной внутренней командой.
Да. Пилот позволяет проверить, насколько эффективно SOC работает с инфраструктурой компании до масштабного внедрения.
В рамках пилота обычно выбирают ограниченный набор наиболее значимых источников: например, Active Directory, VPN, межсетевой экран, EDR/XDR, почту или критичный веб-сервис. По итогам заказчик получает результаты мониторинга, примеры выявленных событий и инцидентов, рекомендации по улучшению защиты и план дальнейшего подключения.
SOC является важным элементом зрелой системы управления информационной безопасностью: он обеспечивает мониторинг, регистрацию событий, выявление инцидентов, реагирование и документирование процессов.
Однако сам по себе SOC не гарантирует автоматического соответствия всем требованиям 152-ФЗ, 187-ФЗ, приказов ФСТЭК, требований Банка России или иных регуляторов. Для достижения соответствия необходима комплексная работа: аудит, модель угроз, организационно-распорядительные документы, внедрение средств защиты, настройка процессов и контроль выполнения требований.
SOC может стать частью такой программы и предоставить данные, отчеты и процессы, необходимые для подтверждения постоянного контроля событий ИБ.
SOC может использоваться для мониторинга и реагирования на инциденты в значимых объектах критической информационной инфраструктуры. Для таких организаций особенно важны непрерывный контроль событий, определение критичности инцидентов, регламент взаимодействия с ответственными сотрудниками и выполнение требований по реагированию.
Перед подключением необходимо определить категорию объектов, состав значимых систем, требования к хранению и передаче событий, порядок взаимодействия с уполномоченными органами и границы ответственности между заказчиком и поставщиком услуг.
Стоимость зависит не только от числа сотрудников компании или серверов. На нее влияют:
- Количество и тип подключаемых источников
- Объем событий и журналов безопасности
- Требуемый режим мониторинга
- Целевые показатели SLA
- Наличие собственной SIEM, EDR/XDR и других средств защиты
- Необходимость интеграции с Service Desk, CMDB, системами управления доступом и другими платформами
- Требования к хранению событий и отчетности
- Необходимость дополнительного расследования, Threat Hunting или работ по реагированию
Чтобы получить расчет, достаточно описать критичные системы, используемые средства защиты, примерный масштаб инфраструктуры и желаемый режим обслуживания.